> ## Documentation Index
> Fetch the complete documentation index at: https://docs.apiyi.com/llms.txt
> Use this file to discover all available pages before exploring further.
# GPT-Image-2.5-VIP 生图/编辑
> GPT 图像生成 Adobe 官逆模型(Firefly 线路) gpt-image-2-vip 及 2.5 姐妹模型 gpt-image-2.5-flare-vip / gpt-image-2.5-sunburst-vip,$0.03/张统一价,支持 10 比例 × 3 档分辨率(1K/2K/4K)共 30 档常见 size,调用方式与 gpt-image-2-all 一致;约 90–150 秒出图,适合需要稳定锁定输出尺寸的场景。
**`size` 参数已恢复可用**(2026-07-22 更新):显式传入 `size` 即可正常锁定输出尺寸,本页 30 档对照表恢复生效。注意:`size` 仅在 `/v1/images/generations` 与 `/v1/images/edits` 端点生效,**`/v1/chat/completions` 聊天补全端点不支持 `size` 参数**,对话方式出图无法锁尺寸。最新状态以 [实时动态](/live) 栏目为准。
图片 API 全部为**同步调用**:没有异步任务 ID,客户端断开连接结果即丢失、但请求仍会计费。请为本模型设置足够大的 timeout,详见 [图片 API 调用须知与最佳实践](/api-capabilities/image-api-best-practices)。
## 概述
**gpt-image-2.5-vip**(别名,指向 `gpt-image-2.5-sunburst-vip`)、**gpt-image-2.5-flare-vip** 与上一代 **gpt-image-2-vip** 是 API易 平台的 **GPT 图像生成 Adobe 官逆模型(Firefly 线路)**——高质量的 GPT-Image 2.5 逆向资源,不是低质量的超分。与 [`gpt-image-2.5-all`](/api-capabilities/gpt-image-2-all/overview) 同价 **\$0.03/张**,**调用方式完全一致**,最大区别是 **支持 `size` 参数**——覆盖 **10 比例 × 3 分辨率档(1K Fast / 2K Recommended / 4K Detail)共 30 档常见尺寸**,含 4K。
**🎨 核心定位**:当你需要**锁定输出尺寸**(电商主图、海报模板、视频封面、4K 壁纸等)时使用 `gpt-image-2.5-vip`。请求体里只需把 `model` 改成 `gpt-image-2.5-vip`、加一个 `size` 字段,其它代码与 `gpt-image-2.5-all` **完全相同**。
**三款 -vip 一家人**:`gpt-image-2.5-vip`(别名,指向 `gpt-image-2.5-sunburst-vip`)、`gpt-image-2.5-flare-vip` 与上一代 `gpt-image-2-vip` 走同一条 Adobe 官逆线路,**价格(\$0.03/张按次)、分组(`Default` / `image2_OSS` / `svip`)、端点、调用方式完全相同**,换 `model` 即可互切。flare-vip 更快、画面偏软;sunburst-vip 画质与编辑精度更高,人眼与 `gpt-image-2-vip` 接近。三款的参数边界与实测差异见下方「三款 -vip 对比」一节。
`/v1/images/generations`,输入文本提示词 + `size` 生成指定尺寸图片。
`/v1/images/edits`,multipart 上传参考图 + 编辑/融合指令。
## 让 AI Agent 帮你接入
在用 Codex / Claude Code / Cursor 开发的话,把下面这段提示词复制给它。它会先抓本页的纯文本版(任意文档页地址后加 `.md`),再按你项目的技术栈写代码——超时、base64 渲染、上传压缩、`size` 的 30 个合法档位这几个高频坑已经写死在要求里。
帮我在当前项目里接入 / 排查 gpt-image-2.5-vip 的「文生图 + 图片编辑」(`gpt-image-2.5-flare-vip` / `gpt-image-2-vip` 同价同调用,模型名做成配置项方便切换)。
先读文档再动手:抓 [https://docs.apiyi.com/api-capabilities/gpt-image-2-vip/overview.md](https://docs.apiyi.com/api-capabilities/gpt-image-2-vip/overview.md) 拿到本页纯文本版;需要更细的参数说明时,text-to-image 和 image-edit 两页同样在地址后加 `.md` 即可。
接入要求:
1. 超时:客户端 timeout 提到 360 秒兜底。图片接口是同步调用,没有任务 ID,客户端一断连结果就丢了、但这次请求照样计费,所以宁可多等也不要过早超时。反向代理、网关、Serverless 执行上限这些中间层也要一起放宽,任何一层小于生成时间都会掐断请求。
2. 返回渲染:默认返回 base64(`b64_json`,不带 `data:` 前缀),也可以显式传 `response_format: "url"` 拿 CDN 直链。**请显式传 `response_format`,不要依赖默认值**——历史上默认行为随分组和负载变化过。走 base64 就要能渲染展示并提供「保存到本地」;走 url 则要注意链接约 24 小时后失效,必须服务端立即下载转存。同一条 `data[]` 里只会有 `url` 和 `b64_json` 其中一个,解析时两种都要兜住。
3. 上传压缩:调 `/v1/images/edits`(multipart)前先压缩参考图——超过 1.5MB 才处理,长边等比缩到 2048px 以内(不放大小图),以质量 0.9 重编码、保持原格式;多图时合计控制在 6MB 以内,单图不要超过 10MB。某张图压缩失败就回退用原图继续,不要因为压缩失败中断整个请求。
4. 尺寸参数:`size` 只能填本页列出的 **30 个档位之一**(1K / 2K / 4K 各 10 档)或者 `auto`,写法是小写半角 `x`,比如 `1536x1024`——不要写成全角乘号、也不要大写 `X`,表外的尺寸不会报错但会被对齐改写(16 倍数对齐、过小抬到最小边),拿到的尺寸可能与请求不同。请把这 30 档做成前台的分辨率下拉,别让用户自由填。`quality` 可以传 `low` / `medium` / `high` / `xhigh` / `max`(`xhigh` / `max` 只有 2.5 两款接受,`gpt-image-2-vip` 传了会被拒;不要依赖 `auto`;注意 2.5 的 `high` 只相当于 `gpt-image-2-vip` 的 `medium`、2.5 的 `max` 才等于它的 `high`);`n` / `aspect_ratio` 不要带(传 `n=3` 会按 3 张扣费但仍然只返回 1 张图);`mask` 不做精确局部重绘,需要就走官转。如果你需要控制 `size`,就必须走 `/v1/images/generations` 或 `/v1/images/edits`,`/v1/chat/completions` 端点不支持 `size`。
5. Key 从环境变量 `APIYI_API_KEY` 读,base\_url 用 [https://api.apiyi.com/v1,不要硬编码进代码、也不要提交进](https://api.apiyi.com/v1,不要硬编码进代码、也不要提交进) git。
6. 限流:RPM 500 以内不用做并发限制。遇到 429 先看 error.message:参数被拒就改参数;上游饱和就退避重试,或查看 [https://docs.apiyi.com/live。](https://docs.apiyi.com/live。)
7. 改完真跑一次文生图 + 一次图片编辑,把出图结果和这两次调用的花费贴给我。
| 要求 | 挡掉的坑 |
| - | - |
| timeout 提到 360 秒 | 主流 HTTP 客户端默认 30-60 秒超时,会在服务端还在正常出图时掐断请求,而**断连的请求照常计费**。详见 [图片 API 调用须知与最佳实践](/api-capabilities/image-api-best-practices) |
| 显式传 `response_format` | 默认值历史上变过;不显式指定就得同时兜住 `url` 和 `b64_json` 两种形态 |
| `size` 锁定 30 档 | 表外尺寸会被改写成别的尺寸;写成全角乘号或大写 `X` 不合法 |
| `quality` 按模型选档、不传 `n` | 2.5 两款六档全开,`gpt-image-2-vip` 传 `xhigh` / `max` 会被拒;2.5 的 `high` 只等于 `gpt-image-2-vip` 的 `medium`;传 `n=3` 会按 3 张扣费但只返回 1 张图 |
| 429 先看 `error.message` | 参数被拒和上游饱和共用 429,处理方式不同 |
| 上传前压缩 | 手机原图动辄 4-5MB,base64 编码后还会再膨胀约 33%。压缩标准见 [图片压缩与输出分辨率说明](/api-capabilities/image-compression-resolution) |
## 与 `gpt-image-2-all` 的关键差异
`gpt-image-2-vip` 与 [`gpt-image-2-all`](/api-capabilities/gpt-image-2-all/overview) 同属逆向通道、同价、同套调用代码。**互相映射**——把同一段请求里的 `model` 字段从一个换成另一个,行为整体一致,差异如下:
| 维度 | `gpt-image-2-all` | `gpt-image-2-vip` |
| - | - | - |
| **渠道** | 逆向 ChatGPT 官网 | Adobe 官逆线路(Firefly) |
| **价格** | \$0.03 / 张 | \$0.03 / 张(所有 size 统一价) |
| **`size` 参数** | ❌ 不接受(写进 prompt) | ✅ 30 档 size,含 4K |
| **4K(如 `3840x2160`)** | ❌ | ✅ 4K Detail 档 |
| **出图速度** | 约 30–60 秒 | 约 90–150 秒(与官转 `gpt-image-2` 持平) |
| **`quality` 参数** | ❌ 不接受 | ✅ 实测生效、不承诺:2.5 两款 `auto` / `low` / `medium` / `high` / `xhigh` / `max` 六档全开(`xhigh` / `max` 2026-09-10 放开),`gpt-image-2-vip` 到 `high` |
| **支持端点** | `/images/generations` + `/images/edits` | 同左(一模一样) |
| **响应格式** | `b64_json`(默认,纯 base64 无前缀)/ `url`(显式传参) | 同左 |
| **适合场景** | 提示词驱动、对尺寸不敏感 | 需要稳定指定输出尺寸(含 4K) |
**一句话决策**:**不需要严格控尺寸、追求出图速度** → `gpt-image-2-all`;**要锁死输出尺寸或要 4K** → `gpt-image-2-vip`;**需要画质参数 `quality` 或 OpenAI 官方完全对齐的字段** → 改用官方版 [`gpt-image-2`](/api-capabilities/gpt-image-2/overview)。
## 三款 -vip 对比(2026-09-09 实测)
同渠道、同令牌、只换模型名的三臂对比 253 次,加串行边界用例 26 次。三款契约逐格一致,差异只在下表标出的几行;`quality` / 透明背景这两项 `gpt-image-2-vip` 历史上不接受、本次实测已接受,**属渠道行为、不作承诺,以实际返回为准**。
| 项 | `gpt-image-2-vip` | `gpt-image-2.5-flare-vip` | `gpt-image-2.5-sunburst-vip`(别名 `gpt-image-2.5-vip`) |
| - | - | - | - |
| 定位 | 上一代 | 2.5 速度优先 | 2.5 画质与编辑精度优先 |
| 价格 / 分组 | \$0.03/张按次;`Default` / `image2_OSS` / `svip` | 同左 | 同左 |
| `quality` | ✅ `auto` / `low` / `medium` / `high`;`xhigh` / `max` ❌ | ✅ 六档全开:`auto` / `low` / `medium` / `high` / `xhigh` / `max`(`xhigh` / `max` 2026-09-10 复测放开) | 同 flare-vip |
| 输出 token(2048×1152) | low 157 / medium 1,413 / high 5,650 | low 157 / medium 367 / high 1,413 / xhigh 2,511 / max 5,650 | 同 flare-vip |
| 档位怎么对齐 | — | 2.5 的 `high` = 2-vip 的 `medium`,2.5 的 `max` = 2-vip 的 `high`;三款最高档 token 相同 | 同 flare-vip |
| 缺省 `size` | 2048×2048 | **1024×1536 竖版** | 2048×2048 |
| 30 档 `size` | 30/30 逐像素命中 | 30/30 | 30/30 |
| 表外 `size` | 不报错:16 倍数原样,非 16 倍数对齐(`1920x1080` → 1920×1088),过小抬到最小边(`512x512` → 816×816) | 同左 | 同左 |
| `mask` | ⚠️ 接受但整图重绘,真实照片三次内外改动比 ≈1 | 同左 | 同左 |
| `background: "transparent"` | ✅ 返回带 alpha 的 PNG | ✅ 单物体提示词四角全透明 | ✅ 同 flare-vip |
| `output_format: "jpeg"` | 静默忽略,仍回 PNG | 同左 | 同左 |
| `n` | 只回 1 张,不要传 | 同左 | 同左 |
| `response_format: "url"` | ✅ | ✅ | ✅ |
| 编辑端点 | 单图沿用输入尺寸,多图以第一张定画幅 | 同左 | 同左 |
| 画质(人眼,6 组同尺寸提示词) | 基准 | 偏软、装饰细节少 | 与 2-vip 接近 |
| 1024² 耗时(串行) | 约 90–150 秒 | 22~138 秒 | 37~120 秒 |
**怎么选**:日常文生图默认 `gpt-image-2.5-vip`;要最快选 `gpt-image-2.5-flare-vip`;要最高 token 档 2.5 传 `max`、`gpt-image-2-vip` 传 `high`(token 量相同)。三款都不做精确 mask,这一项走官转 [GPT-Image-2.5 / 2](/api-capabilities/gpt-image-2/overview)。默认尺寸随上游变动过,要锁尺寸一律显式传 `size`。
## 核心特性
`size` 字段直接接受 30 档常见尺寸,电商主图、海报模板、4K 壁纸都能严格输出
4K Detail 档支持 2880×2880 / 3840×2160 / 3840×1632 等,适合大尺寸交付物
1K / 2K / 4K 所有档位统一 \$0.03/张,4K 不额外加价
请求结构、字段、响应字段与 `gpt-image-2-all` 完全一致,可秒级切换模型名
图内中英文、招牌、海报文字还原稳定,适合信息图与营销物料
原生理解中文描述,无需翻译即可获得高质量输出
支持通过对话描述直接改图,无需蒙版,可多轮迭代
兼容 OpenAI Images API 标准端点 `/images/generations`、`/images/edits`
## 模型定价
| 模型名 | 计费方式 | 价格 | 输出 |
| - | - | - | - |
| `gpt-image-2-vip` | 按次计费 | **\$0.03 / 张** | 单次返回 1 张图片,`size` 字段锁定输出尺寸 |
| `gpt-image-2.5-flare-vip` | 按次计费 | **\$0.03 / 张** | GPT-Image 2.5 速度优先版,参数面同 `-vip`(`quality` 六档全开) |
| `gpt-image-2.5-sunburst-vip`(别名 `gpt-image-2.5-vip`) | 按次计费 | **\$0.03 / 张** | GPT-Image 2.5 画质与编辑精度优先版,参数面同 flare-vip |
**计费说明**:
* **所有 30 档 size 统一定价 \$0.03/张**——4K Detail 不加价
* 失败请求不计费(如鉴权失败、参数校验失败)
* 如需生成 N 张,客户端并行调用 N 次
## 分组介绍
`gpt-image-2-vip` 放在 **`Default` 默认分组** 即可,不需要额外切分组。逆向通道目前供给稳定,不存在像官转那样需要"企业分组"过渡的场景。
| 模型 | 分组 | 备注 |
| - | - | - |
| `gpt-image-2-vip` | `Default` | Adobe 官逆线路(Firefly),统一 \$0.03/张,约 90–150 秒出图 |
| `gpt-image-2-vip` | `image2_OSS` | **1x 倍率(不加价)**,确定性 URL 输出——默认分组资源紧张时不会降级为 base64 |
| `gpt-image-2.5-flare-vip` / `gpt-image-2.5-sunburst-vip` / `gpt-image-2.5-vip` | `Default` / `image2_OSS` / `svip` | 与 `gpt-image-2-vip` 分组完全相同 |
### 需要确定性 URL 输出 → 切到 `image2_OSS` 分组
`gpt-image-2-vip`(及 `gpt-image-2-all`)在默认分组下**实测(2026-07)不传 `response_format` 时返回 `b64_json`**;显式传 `response_format: "url"` 可拿到图片 URL。但默认分组的输出格式**不做承诺**——历史上曾默认返回 `url`、资源紧张时降级为 `b64_json`,行为随负载与渠道版本变化过。
如果你的业务**强依赖 URL 输出**(直接把 URL 落库、前端按 URL 渲染、不接受 base64),请把令牌分组切到 **`image2_OSS`**——这是专为 **URL 输出确定性**设计的分组,**1x 倍率(不加价)**,对 `gpt-image-2-vip` 和 `gpt-image-2-all` 两个官逆模型都生效,保证响应稳定输出图片 URL,不会降级为 base64。
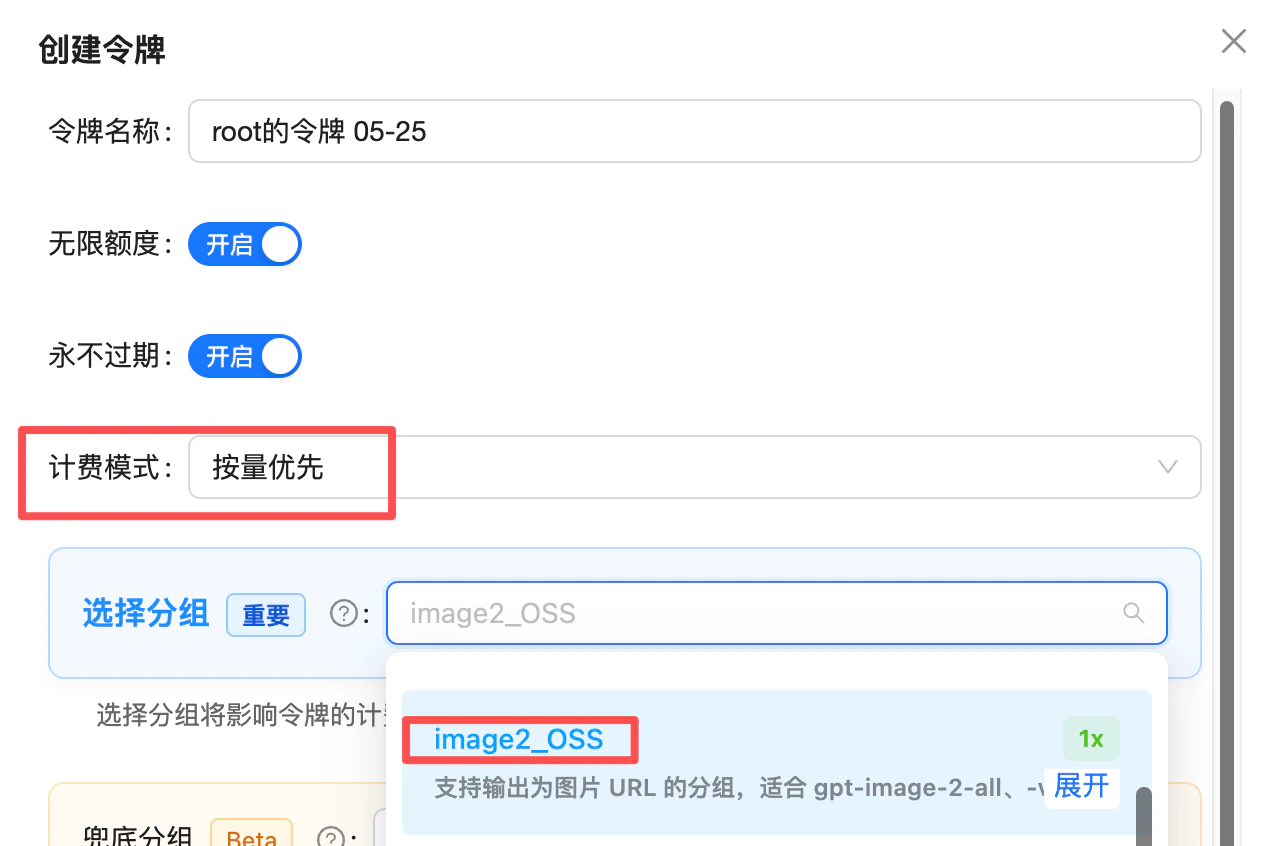 **进阶玩法(同时使用 `gpt-image-2-all` 与官转 `gpt-image-2`)**:如果你的令牌同时覆盖逆向两模与官转 `gpt-image-2`,可以在令牌的「分组优先级」里这样配——
* **第一优先级**:`image2Enterprise`(1.2x 企业分组,官转专用稳定通道)
* **默认(兜底)**:`Default`(逆向两模都在这里,按模型路由)
这样官转 `gpt-image-2` 走企业分组保稳,逆向两模仍走默认分组——一把令牌覆盖三种模型,互不干扰。
📖 关于 `image2Enterprise` 企业分组:[/live/2026-04/image2-enterprise](/live/2026-04/image2-enterprise)
## 技术规格
| 维度 | 参数 |
| - | - |
| **模型名** | `gpt-image-2-vip`;2.5 版本 `gpt-image-2.5-flare-vip` / `gpt-image-2.5-sunburst-vip`(别名 `gpt-image-2.5-vip`) |
| **渠道性质** | 官方逆向(Adobe 官逆线路(Firefly)) |
| **定价** | \$0.03 / 张,按次计费(所有 size 统一价) |
| **出图速度** | `gpt-image-2-vip` 约 **90–150 秒**;2.5 两款 1024² 串行实测 22~140 秒,波动大。RPM 500 以内无需考虑并发。若遇到 `429`,先看 `error.message`:参数被拒(`quality must be one of…`)改参数即可;`当前分组上游负载已饱和` 属偶发,退避重试即可,或联系客服咨询模型状态、查看 [实时动态](/live) |
| **`size` 参数** | ✅ 30 档:10 比例 × 3 分辨率档(1K Fast / 2K Recommended / 4K Detail) |
| **4K 支持** | ✅ 4K Detail 档(如 `3840x2160` / `2880x2880`) |
| **`quality` 参数** | 三款 ✅ 实测生效,属渠道行为不承诺:2.5 两款 `auto` / `low` / `medium` / `high` / `xhigh` / `max` 六档全开(`xhigh` / `max` 2026-09-10 放开),`gpt-image-2-vip` 到 `high`;同名档位 token 量 2.5 低一档(见上方对照表) |
| **`mask` 参数** | ⚠️ 三款接受但不保证只改蒙版区(真实照片实测整图重绘),精确局部重绘走官转 |
| **透明背景** | ✅ 三款 `background: "transparent"` 返回带 alpha 的 PNG(不承诺) |
| **缺省 `size`** | `gpt-image-2-vip` / sunburst-vip 2048×2048,flare-vip 1024×1536;随上游变动,以实际返回为准 |
| **`n` 参数** | ❌ 不支持,单次仅返回 1 张 |
| **默认响应格式** | `b64_json`(纯 base64,**无 `data:` 前缀**,2026-07 实测;建议显式传 `response_format`) |
| **可选响应格式** | `url`(R2 CDN 加速链接,**默认 1 天有效期**,需显式传 `response_format: "url"`) |
| **中文提示词** | ✅ 原生支持 |
| **支持能力** | 文生图、单图编辑、多图融合、自然语言改图 |
**⏰ 图片 URL 有效期:默认 1 天**
`url` 模式响应的 `url` 字段是 R2 CDN 加速链接,**有效期约 24 小时**,过期后访问会 404。需要长期保存的图片请**在生成后尽快转存到自己的对象存储 / CDN / 数据库**,或改用 `b64_json` 响应格式。
## 端点一览
`gpt-image-2-vip` 与 `gpt-image-2-all` 兼容**完全相同**的两个端点。把 `model` 字段换掉、按需加上 `size` 即可:
| 端点 | 用途 | Content-Type | 适用场景 |
| - | - | - | - |
| `POST /v1/images/generations` | 文生图 | `application/json` | OpenAI Images API 标准格式,方便同一套代码同时调用官转与官逆 |
| `POST /v1/images/edits` | 图片编辑(单图 / 多图) | `multipart/form-data` | OpenAI Images API 标准格式,方便同一套代码同时调用官转与官逆 |
**统一使用 OpenAI Images API**(`/v1/images/generations` + `/v1/images/edits`),理由有二:
1. **更稳定**:上游对 Images API 通道的资源供给更充足,调用成功率更高
2. **兼容官转,便于切换**:与官转 [`gpt-image-2`](/api-capabilities/gpt-image-2/overview) 调用方式、`size` 等参数完全兼容——遇到官逆通道风控异常时,**只需更换 `model` 名即可切换**,业务代码零改动
另有对话式端点(`/v1/chat/completions`,不主推),见下方「常见问题」。
**域名选择**:`api.apiyi.com` 为主域名,也可使用 `b.apiyi.com` 等平台提供的其他网关域名,响应行为一致。
## 支持的 size(30 档完整对照表)
`gpt-image-2-vip` 支持 **10 个比例 × 3 个分辨率档 = 30 档** 常见尺寸。请求体直接传 `size: "宽x高"`(半角小写 `x`)。
### 1K Fast — 草稿与低成本试稿
| 比例 | 命名 | 像素 |
| - | - | - |
| 1:1 | Square | `1280x1280` |
| 2:3 | Portrait | `848x1280` |
| 3:2 | Photo | `1280x848` |
| 3:4 | Portrait | `960x1280` |
| 4:3 | Standard | `1280x960` |
| 4:5 | Social | `1024x1280` |
| 5:4 | Large | `1280x1024` |
| 9:16 | Story | `720x1280` |
| 16:9 | Wide | `1280x720` |
| 21:9 | Cinema | `1280x544` |
### 2K Recommended — 默认推荐档(多数终稿)
| 比例 | 命名 | 像素 |
| - | - | - |
| 1:1 | Square | `2048x2048` |
| 2:3 | Portrait | `1360x2048` |
| 3:2 | Photo | `2048x1360` |
| 3:4 | Portrait | `1536x2048` |
| 4:3 | Standard | `2048x1536` |
| 4:5 | Social | `1632x2048` |
| 5:4 | Large | `2048x1632` |
| 9:16 | Story | `1152x2048` |
| 16:9 | Wide | `2048x1152` |
| 21:9 | Cinema | `2048x864` |
### 4K Detail — 大尺寸交付物
| 比例 | 命名 | 像素 |
| - | - | - |
| 1:1 | Square | `2880x2880` |
| 2:3 | Portrait | `2336x3520` |
| 3:2 | Photo | `3520x2336` |
| 3:4 | Portrait | `2480x3312` |
| 4:3 | Standard | `3312x2480` |
| 4:5 | Social | `2560x3216` |
| 5:4 | Large | `3216x2560` |
| 9:16 | Story | `2160x3840` |
| 16:9 | Wide | `3840x2160` |
| 21:9 | Cinema | `3840x1632` |
**30 档统一价**:所有档位都是 \$0.03/张,4K Detail 不额外加价。
**怎么选档位**:
* **1K Fast**:用于草稿、缩略图、A/B 测试,省时(也不省钱,价格统一),出图最快。
* **2K Recommended**:**默认档**,覆盖大部分终稿场景(电商主图、海报、信息图)。
* **4K Detail**:印刷、大屏壁纸、视频封面、桌面 / 户外大图。
**最小调用示例**(只传 `size`;`quality` 可选,见上文):
```bash theme={null}
curl "https://api.apiyi.com/v1/images/generations" \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $YI_API_KEY" \
-d '{
"model": "gpt-image-2.5-vip",
"prompt": "生成一张白色陶瓷马克杯放在灰色桌面上的产品图,柔和自然光,简洁背景",
"size": "2048x1360"
}'
```
## 最佳实践
上传给接口的每张图先压到 **1.5MB 以内**(JPEG 质量 80-90 / 分辨率适当下调),多图融合时也按这个标准逐张控制。偶发的 `shell_api_error` / `Unknown error` 大多就是图片体积过大触发的,压一下请求成功率和出图速度都会明显改善。**输出分辨率由 `size` 字段决定,与输入图体积无关**——压小输入只会提速、不会损画质。提示词里光写 `4K` / `8K` 这类词也不会真给你 4K,画质看 `size`,不看 prompt 修饰词。
草稿用 1K Fast、终稿用 2K Recommended、印刷/大屏用 4K Detail。所有档位统一价,按需要选。
请求体写 `"size": "1536x1024"`,不是 `1536×1024`、不是大写 `X`。
三款 -vip 实测接受 `quality`(不承诺):2.5 两款六档全开(`xhigh` / `max` 2026-09-10 放开),`gpt-image-2-vip` 到 `high`,传 `xhigh` / `max` 会被拒;2.5 的 `high` 只相当于 `gpt-image-2-vip` 的 `medium`,2.5 的 `max` 才等于它的 `high`。`n` 单次仅返回 1 张图,多张请客户端并行调用。
出图典型 90–150s,叠加图片上传/下载与高峰长尾,**保守按 300s 配**,避免大量误超时。
Web 应用直接渲染用 `b64_json`,服务端中转存储用 `url`。
同一套调用代码,把 `model` 在 `gpt-image-2-all` ↔ `gpt-image-2-vip` 之间切换即可。需要锁尺寸时切到 -vip,需要更快出图时切回 -all。
## 错误码与重试
| 状态码 | 含义 | 建议 |
| - | - | - |
| `400` | size 取值不在 30 档内或格式错误 | 用上表中的精确字符串 |
| `401` | 令牌无效 | 检查 Bearer Token |
| `429` | 参数被拒 / 上游偶发饱和 / 额度不足 | RPM 500 以内无需考虑并发。若遇到 `429`,先看 `error.message`:参数被拒(`quality must be one of…`)改参数即可;`当前分组上游负载已饱和` 属偶发,退避重试即可,或联系客服咨询模型状态、查看 [实时动态](/live) |
| `500`(4K 偶发) | OpenAI 上游算力波动,4K Detail 档较易触发 | **优先降到 2K Recommended 档**重试;必须 4K 时改用官转 [`gpt-image-2`](/api-capabilities/gpt-image-2/overview) + `image2Enterprise` 企业分组 |
| `5xx`(其它) | 网关/后端临时错误 | 重试 1–2 次 |
| 超时 | 上游高峰 + 4K 长尾 | 客户端设置 **≥ 300s 超时**(保守值) |
**建议客户端**:
* 请求超时 **300 秒** 起步(保守值;典型 90–150s,但 4K Detail + 高峰长尾会更长)
* 对 5xx 与超时做 **指数退避重试**(建议 2–3 次)
* 记录响应头 `request-id` 方便排查
## 常见问题
**可以,几乎完全一样。** 两个端点(`/v1/images/generations`、`/v1/images/edits`)的请求字段、响应字段、`b64_json` 前缀行为都一致。差异只有两处:
1. `model` 字段:`gpt-image-2-vip` ↔ `gpt-image-2-all`
2. `size` 字段:vip 接受 30 档常见尺寸;-all 不接受 `size`,尺寸要写进 prompt
实际工程实践:保留同一套代码,做一个 `if model == 'vip': payload['size'] = ...` 的开关即可。
`gpt-image-2-vip` 走的是 Adobe 逆向通道(Firefly),**典型 90–150 秒**,与官转 `gpt-image-2`(100–120 秒)持平,比 ChatGPT 网页线路的 `gpt-image-2-all`(约 30–60 秒)慢。如果对**响应延迟敏感**,建议优先用 `gpt-image-2-all`;只在**必须锁尺寸或 4K** 时切换到 vip。
**建议严格用表里 30 档之一**。2026-09-09 实测表外尺寸不再报错,而是被改写后出图:16 倍数的会原样保留(如 `1024x1024` / `1600x1600`),不是 16 倍数的对齐到 16(`1920x1080` → 1920×1088),过小的抬到最小边(`512x512` → 816×816)。拿到的尺寸可能与请求不同,需要严格尺寸时仍按 30 档传。
**现象**:在 4K Detail 档(如 `3840x2160` / `2880x2880`)较容易触发 `status_code: 500` 错误,上游返回 `invalid_request_error`:
```json theme={null}
{
"status_code": 500,
"error": {
"message": "An error occurred while processing your request. ... Please include the request ID xxxxxxxx in your message.",
"type": "invalid_request_error",
"code": null
}
}
```
**根因**:**OpenAI 算力波动**,与请求参数本身无关——同一段请求换 2K 档大概率就过了。逆向通道对 4K 这种大输出的负载更敏感,高峰期更明显。
**应对建议**(按性价比排序):
1. **优先改用 2K Recommended 档**(如 `2048x1360` / `2048x2048`)—— 2K 成功率显著更高,价格同样 **\$0.03/张**
2. **图生图 / 多图融合少传输入图** —— 逆向链路对多入图请求处理压力大,会进一步增加 4K 失败率;单张输入图先压到 **1.5MB 以内**也有帮助
3. **如必须稳定出 4K** —— 切换到官转模型 [`gpt-image-2`](/api-capabilities/gpt-image-2/overview) + **`image2Enterprise` 企业分组**。官转 4K 价格更高(**约 \$0.3+/张**),但稳定性显著更好,适合对 4K 交付有硬要求的场景。
📖 经验来源:[/live/2026-05/gpt-image-2-vip-4k-tips](/live/2026-05/gpt-image-2-vip-4k-tips)
**强烈建议压**。单张输入图压到 **1.5MB 以内**(JPEG 质量 80-90 / 分辨率适当下调):偶发的 `shell_api_error` / `Unknown error` 大多就是图片体积过大触发的,压一下请求成功率和出图速度都会明显改善。注意 1.5MB 是**推荐上限**(追求稳定性与速度),上面 FAQ 写的 10MB 是网关硬上限。
**别担心压输入会损画质**——本模型输出分辨率由 `size` 参数决定,跟你上传图的体积没关系。压小输入只会提速、不会损画质。
**提示词里光写 `4K` / `8K` 这类词也不会真给你 4K**。如果 prompt 写 `8K 超清` 但 `size` 选 `1024x1024`,最终拿到的就是 1K 水平。**要 4K 请在 `size` 字段里指定**——30 档里 1K / 2K / 4K 同价 \$0.03/张,按需要直接选。
📖 排错来源:[/live/2026-05/gpt-image-2-vip-unknown-error](/live/2026-05/gpt-image-2-vip-unknown-error)
**不加价**,4K Detail 档(`3840x2160` / `2880x2880` 等)与 1K / 2K 同价 \$0.03/张。
**不支持。** 本模型单次只返回 1 张图,请通过**重复调用 / 并发调用**的方式生成多张。
⚠️ **重要**:如果在请求里传入 `n=3`,**计费会按 0.03 × 3 = \$0.09 扣费**,但**实际上仍然只返回 1 张图**。请务必把 `n` 字段从请求里去掉,避免被多扣费。
官逆是**同步对话式返回**,结果分两种情况,**计费规则不同**:
**1) 返回 5xx 状态码 → 不计费**
上游内容策略明确拦截时会返回类似:
```json theme={null}
{
"error": {
"message": "没有按照预期生成图片,请重新调整提示词后重试(traceid: 0672821c6951af183dbf847130caaf16)",
"localized_message": "Unknown error",
"type": "invalid_request_error",
"param": "",
"code": null
}
}
```
这种"明确报错"调用**不计费**,引导用户调整提示词重试即可。
**2) 返回 200 状态码(模型用文字软拒绝)→ 计费**
模型在对话里软拒绝、用文字回复(例如「我不能做到这个需求」「抱歉,这个请求涉及……」),从协议层看就是一次正常的对话返回,**这种情况会被计费**。官逆目前没有办法在协议层提前识别"这一段是拒绝文字而不是图片"。
**为什么不能直接对软拒绝免单?**
强行对所有"软拒绝"都不计费意味着平台要为每次失败承担上游成本;更关键的是,**频繁触发上游内容安全会让供应方账号更容易被封号**——这部分供给侧的硬成本也无法完全规避。
**给接入方的建议**
* ✅ **前置内容过滤 / 风险提示**:在前端或接入层先做一道关键词与场景过滤(如真实姓名、版权角色、敏感题材),并在 UI 上提示"涉及名人/版权题材时上游限制较严,可能失败也会计费",能显著降低误扣率。
* ✅ **C 端产品月度补发**:理解 C 端产品无法完全控制用户输入。如果你的月用量较大(**月消费 \$1000+ 起**),可以**按月汇总日志**(短耗时调用通常对应软拒绝)联系客服一次性人工补发,无须逐条申诉。
📖 相关:[官逆 500 多为内容违规](/live/2026-04/gpt-image-2-all-500-content-policy)
**先检测再处理**。2026-07 实测返回的 `b64_json` 为纯 base64(不带前缀),需要解码写文件或自行拼接前缀后再渲染;但**历史版本曾直接带前缀**。请在代码里做 `startsWith('data:')` 检测:有前缀直接用作 `img src`,无前缀先解码,避免双重拼接或带前缀解码产出损坏的图片。
推荐 **单张 ≤ 10MB**,格式 `png` / `jpg` / `webp`。过大的图可能触发网关限制。多图融合时每张都需满足此限制。
`url` 模式响应的 `url` 字段是 **R2 CDN 加速链接,有效期约 1 天(24 小时)**,过期后会 404。
**强烈建议**:生成后尽快把图片 **转存到自己的对象存储(S3 / OSS / R2)、CDN 或数据库**,不要长期直接引用本服务返回的 URL。
本模型为一次性出图,不支持 stream 输出。如果对响应延迟敏感,建议客户端显示"生成中"进度提示,并合理配置 **300s 超时**(保守值)。
可以。把 `base_url` 指向 `https://api.apiyi.com/v1`,`api_key` 设为 API易 令牌即可。`client.images.generate(model="gpt-image-2.5-vip", size="2048x1360", prompt=...)` 直接可用。
可以,端点仍然可用,但**不再主推**——推荐统一使用 `/v1/images/generations` 与 `/v1/images/edits`(更稳定、与官转 `gpt-image-2` 同套代码)。
对话方式仅适合两类场景:多轮迭代改图、需要直接传在线图片 URL。注意出图意图不够明确时可能返回纯文字而不是图片(可在提示词开头加「生成图片:」前缀强化)。
详细参数见 [对话式调用说明](/api-capabilities/gpt-image-2-vip/chat-completions)。
需要**精确**的 mask 局部重绘、需要 OpenAI 官方完全一致的字段行为(含官方承诺的 `quality` 六档)时,改用官转 [`gpt-image-2.5-flare` / `sunburst` / `gpt-image-2`](/api-capabilities/gpt-image-2/overview)。详见 [官转 vs 官逆 对比](/api-capabilities/gpt-image-2/vs-gpt-image-2-all)。
## 相关文档
* [GPT-Image-2-All 概览](/api-capabilities/gpt-image-2-all/overview) - 同价位、出图更快的姐妹模型,适合不需要锁尺寸的场景
* [⚖️ 官转 vs 官逆 对比](/api-capabilities/gpt-image-2/vs-gpt-image-2-all) - 与官方版 `gpt-image-2`(含 `-all` / `-vip`)的选型对照表
* [文生图 Playground](/api-capabilities/gpt-image-2-vip/text-to-image) - `/v1/images/generations` 兼容端点,传 `size` 锁定尺寸
* [图片编辑 Playground](/api-capabilities/gpt-image-2-vip/image-edit) - `/v1/images/edits` 多图融合与改图
* [GPT-Image-2.5 / 2 官方版](/api-capabilities/gpt-image-2/overview) - 需要精确 mask 局部重绘 / OpenAI 官方对齐字段时的选择
* [深度解读:GPT-image-2.5 上线](/news/gpt-image-2-5-launch) - 2.5 双模型发布说明
* [GPT-Image 系列总览](/api-capabilities/gpt-image-series) - 官方 GPT-Image 系列对比
* [API 使用手册](/api-manual) - 通用调用规范
gpt-image-2-vip 属于官逆通道(Adobe 线路,Firefly),行为对齐但定价/能力与官方版本不完全一致。需要官方完全一致字段时,请使用 [`gpt-image-2`](/api-capabilities/gpt-image-2/overview)。
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.