> ## Documentation Index
> Fetch the complete documentation index at: https://docs.apiyi.com/llms.txt
> Use this file to discover all available pages before exploring further.
# 日志查询 API
> 用程序拉取调用日志,获取每次请求的模型、实际扣费、耗时与错误码,实现自动对账与故障自查
## 接口概述
日志查询接口返回你账号下**每一次 API 调用**的明细记录,包括调用的模型、实际扣费、耗时、
是否流式、以及失败时的错误码。
它和[余额查询 API](/api-capabilities/balance-query) 是互补的:余额查询告诉你「现在还剩多少钱」,
日志查询告诉你「钱花在哪了」。
三类典型用途:
按时间段、按模型统计实际消费,与自己的业务账单核对
查失败请求的错误码,定位是参数问题还是上游问题
拿到 `request_id` 给客服,能精确定位到那一次调用
控制台也能看日志(「日志」页面)。本接口是同一份数据的程序化入口,适合需要自动化对账、
定时导出、或接入自己监控系统的场景。手动查看请直接用控制台,见 [如何查看我的调用记录](/faq/call-logs)。
**推荐用法:每天同步一次,把日志落到你自己的库里。**
这个接口是为「定时增量导出」设计的,不适合当成实时查询接口反复调用:
* **每天跑一次**,只拉「上次同步之后」的新记录,写进你自己的数据库或 CSV
* **一次多取一些**:`pageSize` 最大 5000,别用默认的 10 —— 详见下方参数说明里的常见陷阱
* **不要**用它做全量回溯(例如一次性拉三个月),也不要在页面上做实时翻页
* **不要并发**调用,串行一页一页拉,页与页之间留 1 秒左右间隔
* 时间窗跨度**建议不超过 1 天**;调用量大的账号按小时切
原因见下方「性能须知」一节:时间窗越老、翻页越深,单次请求的开销涨得很快,
超过服务端上限会直接返回错误,**重试同样的参数也不会变快**。
本页的 Python 示例已经按这个模式写好,可以直接拿去当每日定时任务用。
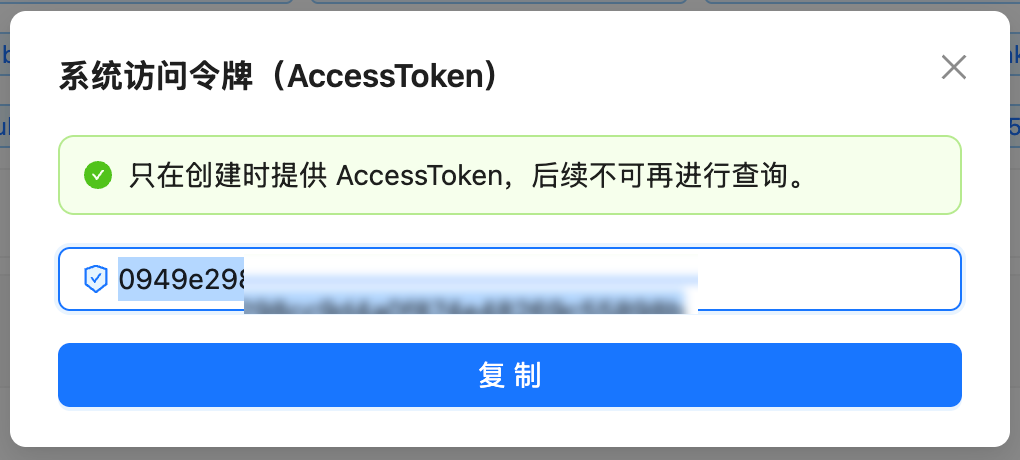
## 如何获取系统令牌
日志接口用**系统令牌**认证,与 API Key 不是一回事(详见文末注意事项)。
访问 `api.apiyi.com/account/profile` 个人中心页面
在页面最下方找到「账号选项 - 系统令牌」部分
输入当前的账户密码后,会得到一个 AccessToken,该密钥可用于后续接口的查询数据
 ## 接口信息
| 项目 | 说明 |
| - | - |
| **接口URL** | `https://api.apiyi.com/api/log/self` |
| **请求方法** | `GET` |
| **认证方式** | Authorization Header(直接填 token 字符串,**不加 `Bearer` 前缀**) |
| **响应格式** | JSON(gzip 压缩) |
| **数据范围** | 仅本账号自己的日志 |
## 请求说明
### 请求 Headers
| Header名称 | 必填 | 说明 |
| - | - | - |
| `Authorization` | 是 | 系统令牌,格式:直接填写 token 字符串 |
| `Accept` | 否 | 建议设置为 `application/json` |
### 查询参数
| 参数 | 类型 | 必填 | 说明 |
| - | - | - | - |
| `p` | Integer | 否 | 页码,**从 0 开始**(不是 1)。偏移量 = `p` × `pageSize` |
| `pageSize` | Integer | 否 | 每页条数,默认 10,**最大 5000**。⚠️ **注意是驼峰**,见下方提示 |
| `type` | Integer | 否 | 日志类型,对账请传 `2`,取值见下表 |
| `model_name` | String | 否 | 按模型名精确过滤,如 `gpt-5.6` |
| `token_name` | String | 否 | 按令牌名过滤 |
| `request_id` | String | 否 | 按请求 ID 精确查单条,命中时只返回那一条 |
| `start_timestamp` | Integer | **必传** | 起始时间,Unix 秒。见下方说明 |
| `end_timestamp` | Integer | **必传** | 结束时间,Unix 秒。与 `start_timestamp` 的跨度建议不超过 1 天 |
| `group` | String | 否 | 按分组过滤 |
**时间窗请当成必填参数。**
接口本身**不强制**这两个参数 —— 不传也能调通。但不传意味着让服务端在你账号的**全部历史**里
从最新往回找,**历史调用量大的账号会直接撞上服务端上限、返回错误而不是慢一点**。
这是本页最容易踩、后果也最直接的一个坑。我们把它标成「必传」不是因为服务端会拒绝,
而是因为**不传的失败方式很难自己看出来**:它不报「参数缺失」,只报超时。
**`pageSize` 是本接口唯一使用驼峰命名的参数,写成 `page_size` 会被静默忽略。**
其余参数(`model_name`、`token_name`、`start_timestamp`、`request_id` …)都是下划线命名,
只有这一个不是。写错不会报错,服务端会**当作没传、回落到默认的每页 10 条** ——
很容易被误认为「上限就是 10」或者「我这段时间只有 10 次调用」。
```
?pageSize=1000 ✅ 返回 1000 条
?page_size=1000 ❌ 静默返回 10 条
```
超过 5000 会明确报错(`每页条数不能超过 5000`),不会静默截断。
**把 `pageSize` 调大是这个接口最有效的一个优化。** 按每页 10 条拉,
一个每天 50 万次调用的账号需要请求 5 万次;按每页 5000 条只要 **100 次**。
请求数少两个数量级,翻页深度也随之降下来 —— 参见下方「性能须知」。
实测每页 5000 条的响应约 700 KB(gzip 后)、2.5 秒左右。
如果你的网络或内存吃紧,`1000` 是个稳妥的折中值。
### 性能须知
单次请求的开销**不是固定的**,取决于三个因素。按这三条来用,这个接口很快;
反着用,会直接撞上服务端 60 秒的单条查询上限并返回错误。
| 因素 | 便宜 | 昂贵 |
| - | - | - |
| **时间窗的位置** | 最近几天 | 几十天以前 |
| **时间窗的跨度** | 1 小时 \~ 1 天 | 一个月,或者干脆不传时间窗 |
| **偏移量(`p` × `pageSize`)** | 前几万条 | 几十万条以上 |
四条实用规则:
1. **一定要传 `start_timestamp` 和 `end_timestamp`。** 不传时间窗是最贵的用法。
2. **`pageSize` 调大。** 这是最省事的一条:每页 10 条改成每页 1000\~5000 条,
请求数直接降两个数量级,偏移量也跟着降。
3. **窗口切小、而不是把偏移量翻深。** 真正贵的不是「第几页」而是「跳过了多少条」——
这个开销是超线性增长的。与其在一个大窗口里一路翻下去,
不如切成 24 个一小时的小窗口,每个窗口的偏移量都从 0 开始。
4. **拉历史数据一次拉完就落库,之后只做增量。** 老数据的查询成本比新数据高得多,
反复回查同一段历史是纯浪费。
如果某个窗口用 `pageSize=1000` 还翻了几十页才结束,说明这段时间你的调用量很大 ——
**把窗口对半切开分别拉**,比继续往深处翻页快得多。下方 Python 示例里的
`MAX_PAGES` 就是干这件事的。
#### 60 秒是硬上限,超了返回的是错误
服务端对单次查询有 **60 秒**的执行上限。超过这个时间,你拿到的**不是一个慢响应,
而是一个错误** —— 已经花掉的时间不会给你任何数据。
以下三种用法**很可能**触发它,请直接避开,不要靠重试去碰运气:
| 用法 | 为什么 |
| - | - |
| **不传时间窗** | 服务端要在你的全部历史里回溯 |
| **时间窗落在一个月以前**,且账号调用量大 | 越老的数据检索成本越高 |
| **偏移量翻到几十万条以上** | 跳过的记录数越多越慢,且是超线性的 |
**重试同样的参数不会变快**,只会再等 60 秒。正确的反应是**把时间窗缩小**、
或者把 `pageSize` 调大以减少翻页 —— 换句话说,让服务端每次要处理的数据量变小。
### 日志类型 type
| 取值 | 含义 | 说明 |
| - | - | - |
| `1` | 充值 | 记录充值前后余额,`quota` 为 0 |
| `2` | **消费** | **对账只需要这一类**,`quota` 是实际扣费 |
| `3` | 管理 | 账号信息变更等操作记录,`quota` 为 0 |
| `4` | 系统 | 系统赠送额度等,`quota` 为 0 |
| `11` | 异步任务退款 | 视频等异步任务失败时全额退回预扣额,`quota` 为**负数**,`content` 里带 task\_id |
**统计花费时务必带上 `type=2`。** 不传 `type` 会把充值、系统赠送记录一起返回,
这些记录的 `quota` 虽然是 0,但 `model_name` 与 `token_name` 也是空的,
直接遍历求和或按模型分组会得到错误结果。
用到视频类异步模型(Seedance 等)的账号,请**再拉一遍 `type=11`**:任务失败时预扣额以负数退款行退回,只算 `type=2` 会把失败单的预扣额当成消费。
## 响应说明
### 成功响应示例
```json theme={null}
{
"success": true,
"message": "",
"data": [
{
"request_id": "2026080114481936471351696e93ae3FTV8WKfk",
"created_at": 1785595715,
"type": 2,
"content": "模型固定价格 0.015,分组倍率 1",
"username": "your-account",
"token_name": "生产环境-主力",
"token_group": "default",
"model_name": "gpt-5.6",
"quota": 7500,
"prompt_tokens": 1000,
"completion_tokens": 0,
"duration_for_view": 16,
"is_stream": false,
"error_code": "",
"other": "{\"billing_type\":\"by_count\",\"request_path\":\"/v1/images/generations\",\"group_ratio\":1,\"model_ratio\":1,\"usage\":{}}"
}
]
}
```
### 关键响应字段
| 字段名 | 类型 | 说明 |
| - | - | - |
| `quota` | Integer | **本次实际扣费**(额度),÷ 500,000 = 美元 |
| `content` | String | 人类可读的计价说明,如「模型固定价格 0.015,分组倍率 1」 |
| `model_name` | String | 实际计费的模型名 |
| `token_name` | String | 哪一把令牌发起的 |
| `token_group` | String | 令牌所属分组(注意是分组标识,见常见问题) |
| `prompt_tokens` / `completion_tokens` | Integer | 输入 / 输出 token 数 |
| `duration_for_view` | Integer | 本次调用耗时(秒) |
| `is_stream` | Boolean | 是否为流式调用 |
| `error_code` | String | 失败原因码,成功时为空字符串 |
| `created_at` | Integer | 调用时间,Unix 秒 |
| `request_id` | String | **请求 ID,报障提工单时提供这个** |
| `other` | String | 计费与请求的补充信息,**是 JSON 字符串,需要二次解析** |
`other` 字段存的是一段 JSON **字符串**而不是嵌套对象,取用前需要再解析一次
(Python 用 `json.loads()`,JavaScript 用 `JSON.parse()`)。里面包含
`billing_type`(计费方式)、`request_path`(实际调用的端点)、`group_ratio`(分组倍率)、
`model_ratio`(模型倍率)、`usage`(用量明细)等。
视频类异步任务的结算记录里另有 `final_quota`(该任务最终总额)、`original_quota`(提交时的预扣额)、
`adjustment_quota`(本条记录的差额)、`actual_tokens`(实际用量),见下方常见问题。
### 额度换算
500,000 额度 = \$1.00 美金 (USD)
**计算公式:** 美金金额 = `quota` ÷ 500,000
**示例:**
* `quota: 7500` → \$0.015 USD
* `quota: 22500` → \$0.045 USD
* `quota: 18` → \$0.000036 USD
这与[余额查询 API](/api-capabilities/balance-query) 是同一套换算口径,可以直接对齐。
## 错误响应
### HTTP 401 - 认证失败
```json theme={null}
{
"success": false,
"message": "You are not authorized to perform this operation. The access token is invalid."
}
```
**原因:** 系统令牌无效、已过期,或误把 API Key(`sk-` 开头)当成系统令牌使用。
**解决方法:** 回控制台重新生成系统令牌,确认 `Authorization` 里填的是**不带 `Bearer` 前缀**的裸值。
## 代码示例
### cURL 示例(单页,快速验证)
```bash theme={null}
export APIYI_SYS_TOKEN='YOUR_SYSTEM_TOKEN'
# 只看最近 1 小时。start/end 一定要带上,不带时间窗的查询很可能超时
END=$(date +%s)
START=$((END - 3600))
curl --compressed -s "https://api.apiyi.com/api/log/self?p=0&pageSize=1000&type=2&start_timestamp=$START&end_timestamp=$END" \
-H "Authorization: $APIYI_SYS_TOKEN" \
-H 'Accept: application/json' | jq '.data[] | {created_at, model_name, quota, request_id}'
```
**必须添加 `--compressed` 选项**,因为 API 返回的是 gzip 压缩内容,否则会得到乱码。
这条命令用来验证令牌配好了没有。真正的对账请用下面的每日同步脚本。
### Python 示例:每日增量同步(可直接当定时任务用)
下面这段是**推荐的标准用法**:每天跑一次,只拉上次同步之后的新记录,写进本地 SQLite。
重复运行是安全的(按 `request_id` 去重),中断之后重跑会从断点继续。
```python theme={null}
"""APIYI 调用日志每日增量同步。建议每天跑一次,例如 crontab: 30 2 * * *"""
import json
import os
import sqlite3
import time
import requests
BASE = "https://api.apiyi.com"
TOKEN = os.environ["APIYI_SYS_TOKEN"]
QUOTA_PER_USD = 500_000
DB_PATH = "apiyi_logs.db"
WINDOW = 3600 # 单个时间窗的跨度(秒)。1 小时对绝大多数账号都够用
PAGE_SIZE = 1000 # 每页条数,服务端最大 5000。⚠️ 参数名是驼峰 pageSize
MAX_PAGES = 50 # 单窗最多翻多少页;超过就把窗口对半切,避免偏移量太深
SLEEP = 1.0 # 每页之间的间隔,串行调用不要并发
FIRST_RUN_DAYS = 7 # 首次运行往回补多少天
HEADERS = {"Authorization": TOKEN, "Accept": "application/json"}
def open_db():
con = sqlite3.connect(DB_PATH)
con.execute("""
CREATE TABLE IF NOT EXISTS logs (
request_id TEXT PRIMARY KEY,
created_at INTEGER,
model_name TEXT,
token_name TEXT,
quota INTEGER,
error_code TEXT,
raw TEXT
)""")
con.execute("CREATE INDEX IF NOT EXISTS idx_created ON logs(created_at)")
con.commit()
return con
def get_page(start, end, page):
resp = requests.get(
f"{BASE}/api/log/self",
headers=HEADERS,
params={
"p": page,
"pageSize": PAGE_SIZE, # 驼峰!写成 page_size 会被忽略、每页只给 10 条
"type": 2, # 2 = 消费,对账只看这一类
"start_timestamp": start,
"end_timestamp": end,
},
timeout=60, # 服务端单条查询上限也是 60 秒
)
resp.raise_for_status()
return resp.json().get("data") or []
def fetch_window(start, end):
"""拉取 [start, end] 这一段。翻页过深时自动把窗口对半切。"""
rows, seen, page = [], set(), 0
while page < MAX_PAGES:
data = get_page(start, end, page)
if not data:
return rows # 翻到空数组即这一窗结束
fresh = [r for r in data if r.get("request_id") not in seen]
if not fresh:
return rows # 整页都是重复,防御性退出
seen.update(r["request_id"] for r in fresh)
rows.extend(fresh)
page += 1
time.sleep(SLEEP)
if end - start <= 1:
return rows
mid = (start + end) // 2 # 这段时间调用量太大,切成两半分别拉
return fetch_window(start, mid) + fetch_window(mid + 1, end)
def sync():
con = open_db()
row = con.execute("SELECT MAX(created_at) FROM logs").fetchone()
cursor = (row[0] + 1) if row and row[0] else int(time.time()) - FIRST_RUN_DAYS * 86400
now = int(time.time())
total = 0
while cursor < now:
end = min(cursor + WINDOW, now)
rows = fetch_window(cursor, end)
con.executemany(
"INSERT OR IGNORE INTO logs VALUES (?,?,?,?,?,?,?)",
[(r.get("request_id"), r.get("created_at"), r.get("model_name"),
r.get("token_name"), r.get("quota"), r.get("error_code"),
json.dumps(r, ensure_ascii=False)) for r in rows])
con.commit()
total += len(rows)
cursor = end + 1
print(f"本次同步 {total} 条,已落库到 {DB_PATH}")
return con
def report(con, days=1):
since = int(time.time()) - days * 86400
print(f"{'模型':32s} {'次数':>6s} {'花费(USD)':>12s}")
rows = con.execute(
"SELECT model_name, COUNT(*), SUM(quota) FROM logs "
"WHERE created_at >= ? GROUP BY model_name ORDER BY SUM(quota) DESC",
(since,)).fetchall()
for model, cnt, quota in rows:
print(f"{model or '(无)':32s} {cnt:6d} {(quota or 0) / QUOTA_PER_USD:12.4f}")
total = sum((q or 0) for _, _, q in rows)
print(f"\n合计 ${total / QUOTA_PER_USD:.4f} USD")
if __name__ == "__main__":
report(sync(), days=1)
```
**输出示例:**
```
本次同步 570 条,已落库到 apiyi_logs.db
模型 次数 花费(USD)
gpt-5.6 128 2.3850
gemini-3-pro-image 30 1.3500
deepseek-chat 412 0.0148
合计 $3.7348 USD
```
落库之后,按模型、按天、按令牌的各种统计都在你自己的库里做,**不需要再回头查接口**。
这既快得多,也避免了「日志保留期到了、想查的数据已经不在」的问题。
### Node.js 示例(单个时间窗)
同样的思路:按小时切窗口、串行翻页、翻太深就把窗口切小。
```javascript theme={null}
const BASE = "https://api.apiyi.com";
const TOKEN = process.env.APIYI_SYS_TOKEN;
const QUOTA_PER_USD = 500_000;
const PAGE_SIZE = 1000; // 服务端最大 5000
const MAX_PAGES = 50;
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));
async function getPage(start, end, page) {
const qs = new URLSearchParams({
p: String(page),
pageSize: String(PAGE_SIZE), // 驼峰!写成 page_size 会被忽略、每页只给 10 条
type: "2", // 2 = 消费
start_timestamp: String(start),
end_timestamp: String(end),
});
const resp = await fetch(`${BASE}/api/log/self?${qs}`, {
headers: { Authorization: TOKEN, Accept: "application/json" },
});
if (!resp.ok) throw new Error(`HTTP ${resp.status}`);
const { data } = await resp.json();
return data || [];
}
// 拉取 [start, end],翻页过深时把窗口对半切
async function fetchWindow(start, end) {
const rows = [];
const seen = new Set();
for (let page = 0; page < MAX_PAGES; page += 1) {
const data = await getPage(start, end, page);
if (data.length === 0) return rows;
const fresh = data.filter((r) => !seen.has(r.request_id));
if (fresh.length === 0) return rows;
fresh.forEach((r) => seen.add(r.request_id));
rows.push(...fresh);
await sleep(1000); // 串行,不要并发
}
if (end - start <= 1) return rows;
const mid = Math.floor((start + end) / 2);
return [...(await fetchWindow(start, mid)), ...(await fetchWindow(mid + 1, end))];
}
const end = Math.floor(Date.now() / 1000);
const logs = await fetchWindow(end - 3600, end); // 最近 1 小时
const total = logs.reduce((sum, r) => sum + (r.quota || 0), 0);
console.log(`${logs.length} 次调用,合计 $${(total / QUOTA_PER_USD).toFixed(4)} USD`);
```
`fetch` 会自动处理 gzip 解压,Node.js 侧无需额外配置(Python 的 requests 同理)。
只有 curl 需要显式加 `--compressed`。
## 典型场景
### 场景一:每日对账(推荐做法)
把上面的 Python 脚本挂成每天一次的定时任务,日志落到本地库;
统计花费、按模型分组、按令牌拆分这些事,全部在**你自己的库里**用 SQL 做。
这样做有三个好处:查询是本地的所以很快;不受日志保留期影响;
也不会因为反复回查历史数据而拖慢接口。
如果只想同步某个模型的记录,在请求参数里加 `model_name` 即可。
### 场景二:找出失败的调用
落库之后直接查本地表:
```sql theme={null}
SELECT created_at, model_name, error_code, request_id
FROM logs
WHERE error_code != '' AND created_at >= strftime('%s', 'now', '-1 day')
ORDER BY created_at DESC;
```
被网关拒绝的请求(参数错误等)`quota` 为 0,**不产生扣费**。日志里能看到 `error_code`,
方便你区分「调用失败了」和「调用成功但结果不满意」。
### 场景三:报障时提供 request\_id
在日志里定位到出问题的那次调用,把 `request_id` 提供给客服,可以精确查到该次请求的
完整链路。这比描述「大概几点调用 xx 模型失败了」高效得多。
## 常见问题
先检查这三件事,绝大多数慢查询都出在这里:
1. **有没有传 `start_timestamp` / `end_timestamp`?** 不传时间窗是最贵的用法,
服务端会在你的全部历史里回溯。
2. **时间窗是不是太老或太宽?** 查一个月前的数据比查昨天贵得多;
跨度也建议压到 1 天以内,量大的账号按小时切。
3. **`p` 是不是已经翻到几千页?** 翻页开销是超线性增长的。
正确的做法是**把时间窗切小、让每个窗口只翻几十页**,而不是在一个大窗口里往深处翻。
**重试同样的参数不会变快。** 遇到超时请按上面三条调整参数,
而不是原样重试 —— 原样重试只会再等一次。
**十有八九是参数名写成了下划线的 `page_size`。**
正确的写法是驼峰 `pageSize`。这是本接口唯一一个驼峰参数,其余(`model_name`、
`token_name`、`start_timestamp` 等)都是下划线,很容易顺手写错。
写错不会报错,服务端会当作没传、回落到默认的每页 10 条。
```
?pageSize=1000 ✅ 1000 条
?page_size=1000 ❌ 10 条
```
最大 5000,超过会明确报错。数据量大时仍然需要翻页(`p=0`、`p=1` …),
翻到返回空数组为止 —— 上面的 Python 与 Node.js 示例已经封装好这个逻辑。
可以,传 `request_id` 即可,命中时只返回那一条:
```bash theme={null}
curl --compressed -s "https://api.apiyi.com/api/log/self?request_id=YOUR_REQUEST_ID" \
-H "Authorization: $APIYI_SYS_TOKEN"
```
排查某一次具体调用时,这比按时间段拉一堆记录再筛要快得多。
不是。部分字段属于平台内部信息,普通账号视角下为空或 0,属正常现象,
不影响对账与排障需要的字段(`quota`、`model_name`、`error_code`、`request_id` 等都是完整的)。
接口返回的是分组的**标识符**,控制台显示的是分组的**展示名**,两者可能不同。
例如接口返回 `default`,控制台显示「Default」。
完整的对应关系可以从公开接口 `https://api.apiyi.com/api/pricing` 的 `usable_group`
字段获取,它是一个「标识符 → 展示名」的映射表。如果你要让自己的报表和控制台显示一致,
需要自己做一次映射。
以 `quota` 为准。`quota` 是本次调用**实际扣除的额度**,是唯一可用于对账的字段。
响应体里的 token 数在部分按次计费的模型(如出图、视频类)上可能是占位值,
不参与计价 —— 这类模型的计价方式在 `other.billing_type` 里会标为 `by_count`。
**请按「只有最近 30 天可查」来设计你的同步逻辑。**
实际可查询的范围通常比 30 天更长,但我们**不对保留期做承诺** ——
它会随日志清理策略调整,而且不会单独通知。把 30 天当成规划下限,
你的对账流程就不会因为清理策略变化而断掉。
另外,**越老的时间窗查询成本越高**,即使数据还在,查起来也慢得多。
所以正确的用法是**每天同步一次、把数据落到你自己的库里**,历史统计在本地做。
需要长期留存的账单数据,请务必自行归档,不要依赖这个接口回查。
**原因:** API 返回的是 gzip 压缩内容(`Content-Encoding: gzip`),curl 没有自动解压。
**解决方案:** 添加 `--compressed` 选项:
```bash theme={null}
curl --compressed 'https://api.apiyi.com/api/log/self?p=0' \
-H "Authorization: $APIYI_SYS_TOKEN" | jq
```
Python 的 requests 与 Node.js 的 fetch 会自动解压,无需额外配置。
Seedance 等异步视频任务按「提交时预扣、完成后多退少补」计费,所以一条视频在日志里是两条记录:
预扣行(`completion_tokens` 为 0、有 `request_id`)和结算行(`completion_tokens` 是实际用量、
**`request_id` 为空**、`quota` 只记差额)。**两条记录里都没有 `task_id`**,本接口没法按任务逐单配对。
要查一条视频的真实消费,请用任务接口按 `task_id` 查,返回的 `quota` 就是两条之和:
```bash theme={null}
curl --compressed -s "https://api.apiyi.com/api/task/self?p=1&page_size=1&task_id=YOUR_TASK_ID" \
-H "Authorization: $APIYI_SYS_TOKEN"
```
注意它的分页参数是下划线 `page_size`、`p` 从 1 开始,与本接口相反。
失败的任务 `quota` 仍显示预扣额,真实消费为 0(日志里有 `type=11` 的负数退款行)。
完整说明见 [如何按 task\_id 查一条 Seedance 视频的真实消费](/faq/seedance-task-cost-lookup)。
不会。日志查询接口不消耗任何配额。
## 注意事项
**系统令牌不是 API Key,两者不能互换**
* **API Key**(`sk-` 开头)用于 `/v1/*` 推理端点,拿去调 `/api/log/self` 会返回 401
* **系统令牌**(一串不带前缀的字符)用于 `/api/*` 管理端点,拿去调 `/v1/chat/completions` 会返回 `Invalid token`
系统令牌的权限范围覆盖整个账号,请**像保管账号密码一样保管它**:存进密钥管理工具而不是代码,
不要提交进代码仓库,定期轮换。
**日志响应里含有你自己的 API Key 明文**
日志记录会返回发起该次调用的令牌信息。**不要把日志的原始响应直接贴到公开场合、
截图发群、或转交给第三方**,导出前先剔除敏感字段。
特别提醒:这段明文不带 `sk-` 前缀,**常见的密钥扫描工具可能扫不出来**,
不要依赖自动化检查兜底。
**建议的调用节奏**
* **每天同步一次**即可,不需要更频繁;同步的是「上次之后的增量」
* **`pageSize` 用 1000\~5000**,不要用默认的 10 —— 这一条比其它几条加起来都管用
* **串行调用**,页与页之间间隔 1 秒左右,**不要并发**
* 客户端超时设成 60 秒(服务端单条查询的上限也是 60 秒)
* 每个时间窗的跨度不超过 1 天;调用量大的账号按小时切
* 遇到超时**先缩小时间窗再重试**,原样重试不会变快
这些不是硬性配额,而是能让你自己拿到结果最快的用法。
按这个节奏用,一个普通账号同步一天的日志通常在一分钟内跑完;
即使是每天几十万次调用的重度账号,一天也只需要一百次左右的请求。
**我们保留未来对本接口引入调用频率限制的权利。**
目前没有对它设置频率限制,但请**不要按「永远不限」来设计你的定时任务**。
按上面这个节奏(每天一次、串行、`pageSize` 调大)用,即使将来加了限流也不会影响到你。
* [余额查询 API](/api-capabilities/balance-query) —— 查账号剩余额度
* [令牌管理 API](/api-capabilities/token-management) —— 程序化创建与管理 API Key
* [如何查看我的调用记录](/faq/call-logs) —— 控制台手动查看
* [日志与账单怎么看](/faq/log-billing-explained) —— 计费字段解读
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.